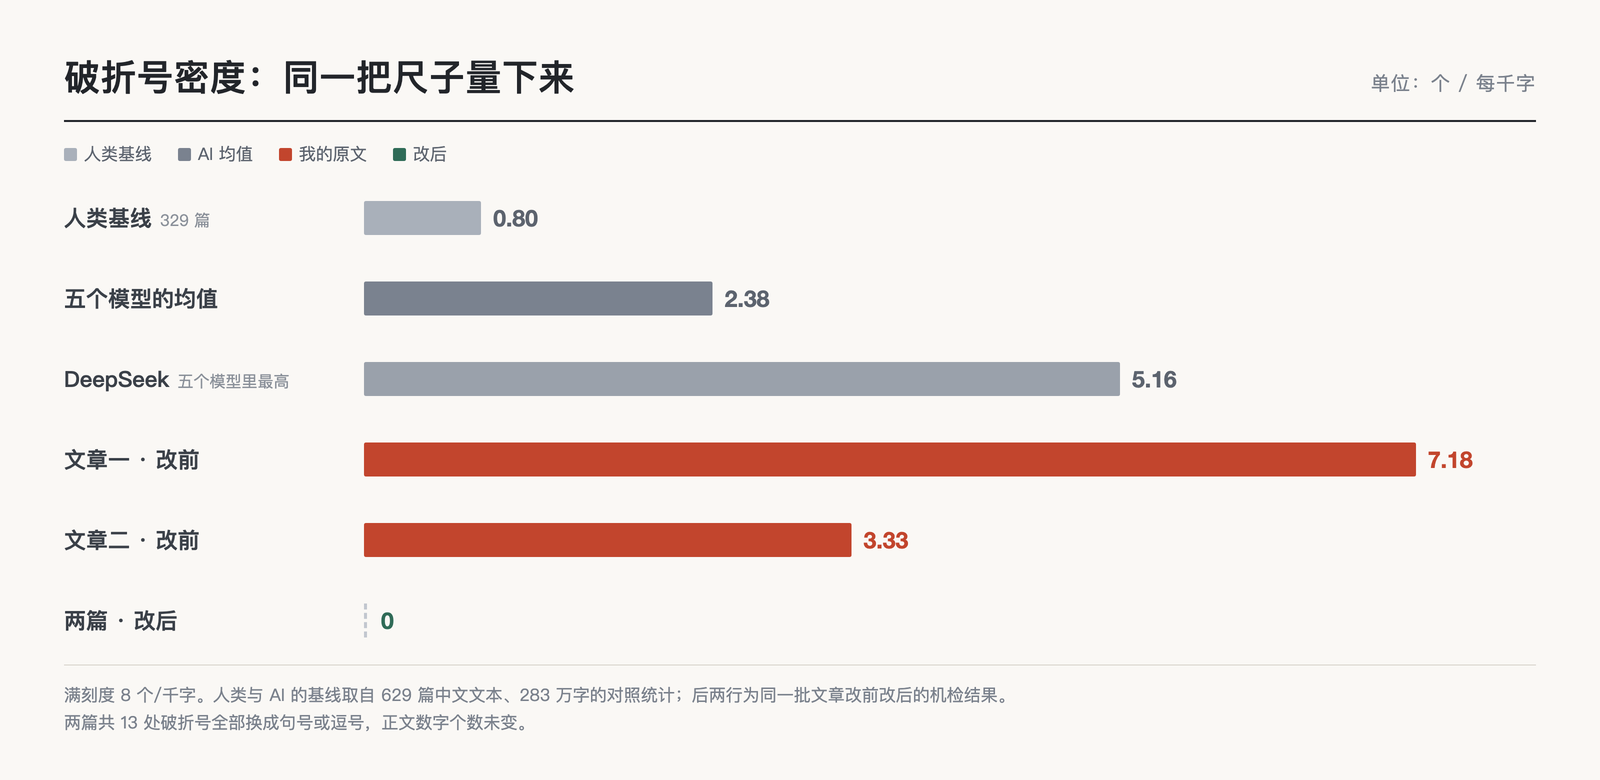
我把自己手上两篇文章量了一下,破折号密度是 7.18 和 3.33,单位是每千字。
人类写作的基线是 0.80。这个数字来自一份 629 篇文章、283 万字的对照研究:五家模型各写 60 篇,人类文本 329 篇,同一个特征在两边分别算频率。按它的尺子,我比这份研究里破折号最重的模型(DeepSeek,5.16)还重。
这结论不好受,但数据就摆在那儿。于是我把做出这份研究的技能装上,拿两篇稿子做了对照测试,27 处改动,正文破折号清零,数字一个没少。
它是一份对照实验,不是一个润色工具
项目叫 lieflat-less-ai-tone,作者在 GitHub 上是 larashero3-dotcom,同一个账号下还有公文写作、图表、卡片一整套技能,这个是专攻中文文风的那个。
它做的事不复杂。先收集 629 篇中文文本、合计 283 万字,其中 300 篇由 Claude、DeepSeek、Gemini、GPT、Kimi 五个模型受控生成,另外 329 篇是人类写的。然后拿市面上流传的 26 个「AI 文风特征」,逐个在两边算频率比。
26 个特征里只有 11 个成立,另外 15 个被数据推翻。成立的那 11 条写成改写规则,被推翻的 15 条单独归档,并注明人类用得更多、不要删。
仓库里全是文档。SKILL.md 是 453 行改写规则,RESEARCH.md 是 284 行研究记录,三个 Python 脚本合计 368 行,只负责统计。装法有两种,用 npx 装成技能,或者直接把 SKILL.md 当系统提示词喂给模型。MIT 许可,发文时实查 3563 星、212 个 fork。
我原来以为 AI 味是词表问题
用之前,我对「AI 味」的理解很朴素,就是一张词表,比如「因此」「综上」「值得注意的是」「在当今这个时代」。写东西时我会特意绕开这几个词,绕开了就觉得自己干净了。
这份研究把流传的 26 个特征逐个测了一遍,11 条成立,15 条不成立。被推翻的那批里,有几条跟直觉正好相反。
| 流传的说法 | 实测(AI 对 人类) | 结论 |
|---|---|---|
| AI 句长均匀度是人类的 50 倍 | 0.58 对 0.67,即 0.87 倍 | 原来的 51 倍是切句缺陷造成的假象 |
| AI 爱用问句当小标题骨架 | 占小标题 2.7%,人类最高 3.6% | 「每千字 32 倍」是分母选错了 |
| AI 爱自问自答 | 0.13 对 0.13 | 三轮测量结论全部翻转 |
| AI 少用「就、很、了」 | 2.93 对 6.45 | 方向是补,不是删 |
| AI 爱写三连排比 | 2.35 对 3.87 | 句内人类更多,只有句间成立 |
| AI 爱堆比喻 | 0.16 对 0.38 | 人类多 2.4 倍 |
最后两行跟直觉冲突得最厉害。按「读着像 AI 就删」这个路子去删比喻、删排比,改完只会更不像人写的。研究里还有个更狠的数字,正文问句人类是 AI 的 17 倍,删设问等于亲手抹掉最像人的那部分。
这也解释了为什么市面上的去 AI 味教程大多不好用。它们给的是「读起来像 AI」的直觉,而直觉在这几项上恰好是反的。
它给的是一份「改与不改」的清单,不是一个检测器
装之前我以为会拿到一个打分工具。实际拿到的就是那几份文档,里面一个 Web 界面都没有。
规则部分是白名单式的。11 条成立的特征各配一条改写方法,没命中这些特征的句子逐字保留。硬性边界写在最前面:不许新增信息,不许删减信息。它还专门列了一节「不作为改写理由」,把「读起来不够流畅」「想换个说法」这类动机挡在外面。
这一点决定了它跟通用的润色指令是两回事。润色会顺手帮你调整语气,它只动清单里那 11 条,多一处都不许。
两篇文章的对照测试,27 处改动
测试用的两篇稿子都一千二百字上下,题材和写法一致,一篇偏解释、一篇偏判断。为了让对比只反映文风,两篇都用同一个流程过,改动前后都跑了同一套统计。
| 指标 | 人类基线 | 第一篇 改前 / 改后 | 第二篇 改前 / 改后 |
|---|---|---|---|
| 破折号(每千字) | 0.80 | 7.18 / 0 | 3.33 / 0 |
| 序数词小标题 | 每千字 0.06 | 6 连号 / 0 | 5 个 / 0 |
| 冒号提示语 | 0.08 | 4 处 / 0 | 0 处 / 0 |
| 正文汉字 | — | 1254 / 1208 | 1202 / 1193 |
| 数值个数 | — | 9 / 9 | 26 / 26 |
改法只有三类,都不需要重写句子。
- 破折号换成句号或逗号。两篇合计 13 处破折号,每一处都在用停顿制造揭晓感。「人像边缘已经是白的了 —— 透明通道早在那次保存里就丢了」,换成句号之后意思一个字没动,那个「且听我揭晓」的节奏没了。
- 小标题编号全拆。「一、二、三」连同「四、五、六」一起删掉,标题文字一字未改。编号不影响句子通顺,但会把小标题的说明功能挤到次要位置,读着像文档。
- 删掉替读者下结论的提示语。「换句话说:」「所以有条铁律:」「原理很简单:」这类句子本身不携带信息,只负责宣布下面要说话了。删掉之后,句子直接从判断开始。
拿一段出来看
原句是这样。
注意 PNG 那条几乎顶满 —— 它把照片原样存下来,一个像素都不丢,代价就是体积。换句话说:PNG 大,是因为它老实。
改完是这样。
注意 PNG 那条几乎顶满,它把照片原样存下来,一个像素都不丢,代价就是体积。PNG 大,是因为它老实。
两个动作,破折号变逗号,删掉那四个字的提示语。判断还在,语气没了。
这里有个细节值得记。规则明确写了哪些情况不改,比如表格单元格里的顿号清单、引用原文、代码注释。我第一次跑机检时,残留的 4 处顿号全在表格内,按规则就该留着。要是照着「顿号一律删」的直觉去改,表格会被拆散。
比「删什么」更值钱的,是它写了「不许删什么」
这类清单最容易变成「越改越干净」的滑坡,它用数据把滑坡堵住了。
研究里被推翻的 15 条,作者没有删掉了事,而是单独列了一节,写清楚人类用得更多、别删。我把这一节抄进了自己的写作规范,因为它的作用比正面清单更大:正面清单告诉你哪里该动手,负面清单告诉你哪里动手会坏事。
实际改稿时这条救过我一次。第二篇里有个问句小标题,我第一反应是改成陈述句,觉得问句太像 AI。查了数据才知道问句小标题人类占 3.6%,AI 只有 2.7%,我那一下会把它改得更假。
缺口在工具层,得自己补
这是用下来最不满意的地方,也是最值得说的地方。
仓库里那三个脚本能直接跑,368 行。拿它跑我的两篇文章,结果跟肉眼数出来的对不上。
第一篇里,脚本报「翻案腔 0 处」「序数词小标题 0 处」。实际是 2 处和 6 连号。原因是正则的覆盖范围比规则名称窄:翻案腔那条正则只写了「而是」,而规则文字里明确包含「不是 A,是 B」这种形式;序数词那条只认「第一」「首先」,不认「一、二、三」这种编号写法。
这不是脚本写得马虎。作者自己在研究笔记里记了六次同类事故,有一次是「AI 句长均匀度是人类 50 倍」,后来发现是切句代码有缺陷造出的假象,真实倍率 0.87。他的总结是,误差来自算子与规则名称之间的覆盖范围落差,而频率数字本身不提示这个落差。
这句话我记住了。规则文字和正则表达式之间永远有一道缝,频率表看不出来。所以照着手工过一遍是必须的,脚本只能当参考。
我的做法是把 11 条规则的文字重新落成阈值,写成一个检查脚本,阈值直接取研究里的基线。改前跑出 exit=1,三项超标;改到 exit=0 才允许发。规则管方向,脚本管验收,两个都得有。
谁该用,谁别用
项目在 larashero3-dotcom/lieflat-less-ai-tone,MIT 许可,中文文档,英文版也带了一份。
适合中文长文写作者。做自媒体、写技术博客、写公众号,只要在意「读起来像不像人说话」,这套规则都能用,改造成本也低,因为它不动你的句子。
不适合的也有两类。本来就要模板感的场景别用,比如公文、说明书、接口文档,编号和固定句式在那里是优点。英文写作也别用,这套基线全部来自中文语料,搬过去没有依据。
还有个前提得说清楚。它是提示词规则集,效果取决于执行它的模型愿不愿意逐字保留。我用下来最稳的方式是把它和机检绑在一起,让模型改完必须过阈值,否则它很容易顺手多改几处,把不该动的也动了。
最后补一句成本。它没有界面、没有安装依赖、不联网,跑一遍只花模型调用本身的钱。对个人写作者来说,这个门槛基本等于零。
回到开头那两个数字。7.18 未必说明我写得敷衍,更可能是压根没意识到破折号密度这回事。能算出来的东西才谈得上改,这也是它比一般「去 AI 味教程」有用的地方,把「像不像人写」拆成了几个能上秤的数。