先说结论。VoiceStudio 能在半年里从 0 涨到五万 star,靠的是一个极好的标签——「完全本地、开源的 ElevenLabs 替代」。可我把它的源码翻了一遍之后,真正让我改观的是另一件事:它自己没训练任何模型。
整个仓库 3275 个文件,属于「模型」的部分几乎全是引来的:默认引擎是 k2-fsa/OmniVoice,另外挂了一长串可选引擎,从 CosyVoice 3 到 sherpa-onnx。它自己写的那层是编排——怎么把十几个依赖互相打架的 Python 环境塞进同一个桌面 App,怎么把这堆能力包装成一台脚本和 Agent 都能直接调的本地服务。
这个判断不是抠字眼。它是模型还是壳,直接决定你该不该装它、以及装完之后到底在维护什么。
| 项目名片 | 信息 |
|---|---|
| 项目地址 | github.com/debpalash/VoiceStudio |
| 官网 / 下载 | voicestudio.sh |
| 主要语言 / License | Python + TypeScript(Electron)/ AGPL-3.0-only;模型权重各自授权 |
| Stars(发文时实查,会变) | 52,023(2026-10-03 查 GitHub API,fork 5,795) |
| 最新版本 | v0.5.6(2026-09-23 发布) |
| 适合谁 | 有独立显卡或 Apple Silicon、又在意素材不出本机的内容/播客/视频团队;以及想把语音能力挂进自动化流程的 Agent 开发者 |
先看它凭什么半年到 5.2 万 star
建仓时间是 2026-04-09,到 10 月 3 日实查 52,023 star、5,795 fork、84 个未关 issue。这个斜率放在整个 GitHub 上都不算常见。
但它不是匀速涨的。翻 Release 记录能看到节奏一直很稳:0.5.0(8 月 13 日)到 0.5.6(9 月 23 日)基本一周一版。真正的拐点在 9 月 26 日之后。
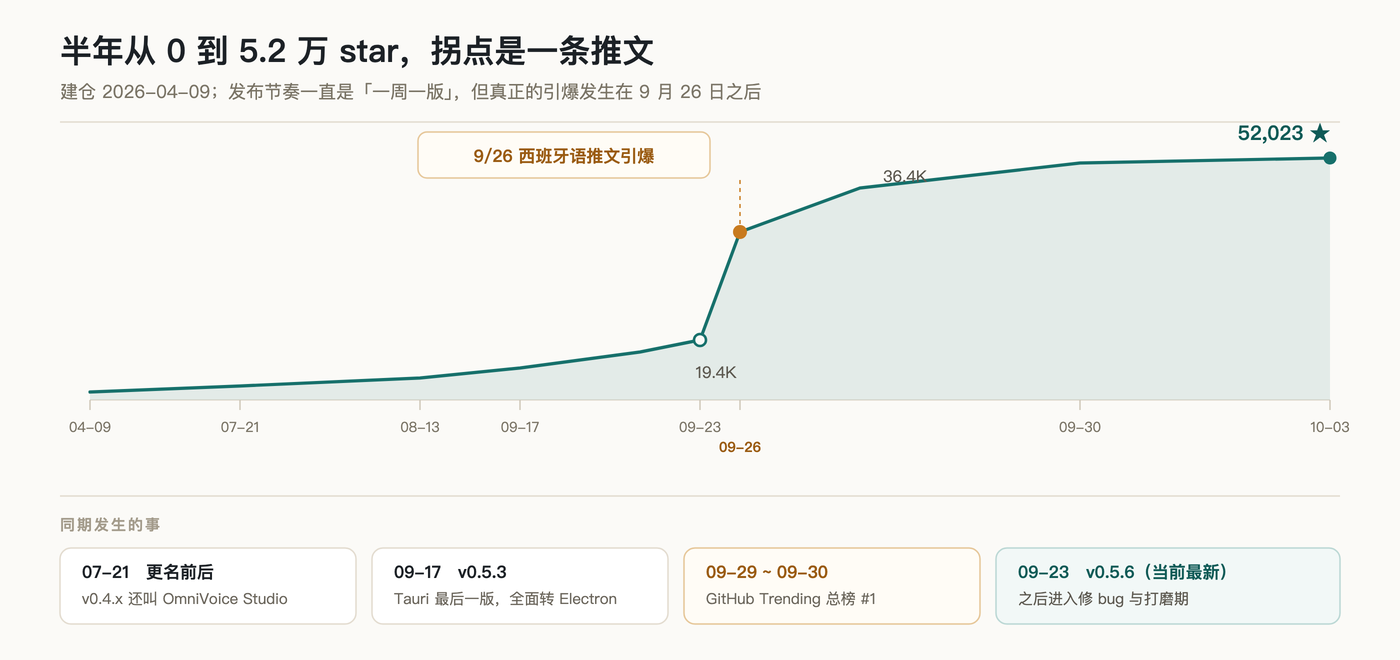
第三方开发者站点 gitnova.dev 的追踪记录显示,9 月 29 日该项目单日涨 4,712 星、9 月 30 日涨 3,481 星,这两天都排在 GitHub Trending 总榜第一;当周累计约 +16,114 星,排周榜第 3。(第三方数据,我没逐条复核原始榜单,但方向和量级与 GitHub API 的实查总星数对得上。)
9 月 26 日发生了什么?一条西班牙语的推荐推文。据科技媒体 NXplace 的报道,那条推文在约九小时内拿到 27.2 万次浏览、7,300 次点赞、4,200 次转发;它引用仓库时 star 数还是 1.94 万,该媒体第二天上午再看已经变成 3.64 万。同一篇报道里那句拿到 4,100 赞的评论挺点题——「本地这部分才是真故事」。
有意思的是 Hacker News 并不是它的主战场。gitnova 记录里那条 HN 帖子只有 6 分。也就是说这个项目的爆发基本是社交传播驱动的,不是工程社区慢慢攒出来的口碑。这一点对判断它的成熟度很重要,后面我会说。
拆开看:Electron 只是壳,真正对外的是 3900 端口
官网把它描述成一个桌面应用——下载 dmg/exe/AppImage,打开就能用。但按源码的结构,它更像一台被塞进桌面壳里的本地语音服务器。
数一下模块规模就很清楚(下面这条命令我自己跑过,不需要 clone 全仓):
# 用 GitHub API 数模块,不用 clone 133MB 的仓库
curl -s "https://api.github.com/repos/debpalash/VoiceStudio/git/trees/main?recursive=1" \
  | python3 -c "
import json,sys
tree=json.load(sys.stdin)['tree']
blobs=[t['path'] for t in tree if t['type']=='blob']
print('总文件数', len(blobs))
for d in ['backend/api/routers','backend/services','backend/core','backend/engines','electron/src']:
    print(f'{d:24s}', len([p for p in blobs if p.startswith(d+'/')]))
"
# 总文件数 3275
# backend/api/routers         46
# backend/services           106
# backend/core                55
# backend/engines             40
# electron/src              1649
前端(electron/)占了将近一半的文件量,后端才是那个「重」的部分:46 个路由文件、106 个 service 文件、55 个 core 文件。这不是一个「几个按钮调一下模型」的 GUI。
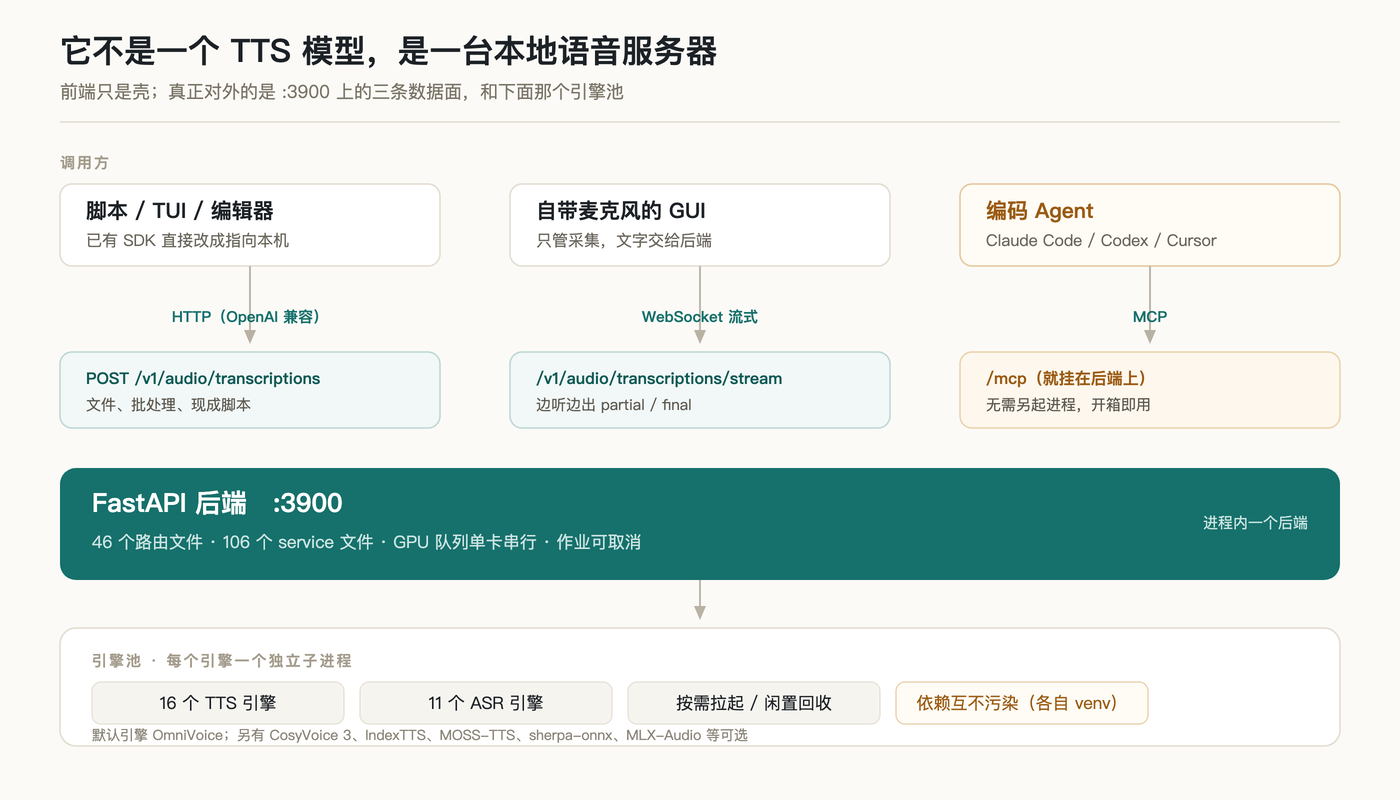
官方文档 docs/speech-platform.md 里那张图把定位写得很直白:桌面应用负责麦克风采集、听写快捷键和文本插入;Python 后端负责把 ASR 模型常驻在内存里,并把音频数据面暴露给任何其他界面。同一份文档给了三条入口——OpenAI 兼容的 POST :3900/v1/audio/transcriptions、流式的 WebSocket /v1/audio/transcriptions/stream(返回 partial / final),以及挂在后端上的 MCP。
我特别喜欢它在迁移文档里留下的一句注脚:Tauri 版本曾经在 3902 端口跑了一个本机听写控制服务,Electron 版不提供它,而且 3902 现在被开发服务器占用了。这种「旧接口已退役、新端口另有用途」直接写进文档的做法,比悄悄删掉接口让人安心得多。
源码里三处比「646 语言」更值得看的设计
「646 种语言」是这个项目传播最广的一句话。我查了它的出处:docs/languages.md 第一行写着,VoiceStudio 支持 646 种语言、合计 58.1 万小时训练数据,紧接着一句限定——「这张目录描述的是 OmniVoice 模型,其他引擎各有自己的语言集」。
也就是说,646 是默认引擎的语言目录,不是你选任何一个引擎都能得到 646 种。这句话被很多转述省掉了。顺带一提,那个目录里的语言条目细到什么程度呢——第 15 条是「Algerian Saharan Arabic」,训练数据 2.02 小时。看到这个数字你就明白,语言数量和语言质量是两件事。
真正让我觉得作者懂行的是另外三处细节。
一、本地生成也带水印,而且是默认行为
backend/services/watermark.py 里做了两层水印。隐形层用 Meta 的 AudioSeal,把一段 16 位信号嵌进音频,代码里那个常量长得很有意思:
# 16-bit message: "OM" in ASCII = 0x4F 0x4D = 0100_1111 0100_1101
# This is our signature — every VoiceStudio-generated audio carries it.
OMNI_MESSAGE = [0, 1, 0, 0, 1, 1, 1, 1, 0, 1, 0, 0, 1, 1, 0, 1]
「OM」两个字母,就是 OmniVoice 的缩写。文件头注释还写了这层水印要能扛住压缩、重采样和二次剪辑。可见层是可选的签名音,视频导出还能叠 logo。
这个设计放在一个主打「全本地、素材不出机器」的项目里,我觉得是对的。本地不等于无法追溯,尤其是当它能克隆任意人的声音时。
二、哪些引擎的许可需要你亲自点头,它写成了代码
backend/core/engine_licenses.py 整个文件只有三行,第 3 行是全部内容:
LICENSE_GATED_ENGINES: frozenset[str] = frozenset({"supertonic3", "pockettts"})
意思是:十六个 TTS 引擎里,只有 supertonic3 和 pockettts 这两个首次使用前必须在本地确认许可。作者没有笼统地让你「同意全部条款」,而是把「哪几个模型的许可需要单独确认」显式列了出来。
这跟它 README 的措辞是一致的:应用本体是 AGPL-3.0,但模型权重各自保留自己的条款。默认那个 k2-fsa/OmniVoice,在 LICENSE-NOTICE.md 里被拆得很细——代码 Apache-2.0,但预训练权重标注为 CC-BY-NC,而它内部的 audio_tokenizer/LICENSE 还含 Meta Llama 的社区条款。这几层许可叠在一起,商用前是要单独过一遍的。
三、它不替你修 macOS 的隔离属性,因为修不了
从浏览器下载的 dmg,macOS 会给 .app 打上 com.apple.quarantine 扩展属性。首次启动时这个属性会传染到包内每个二进制,Gatekeeper 就拒绝执行——用户看到的是「VoiceStudio 无法打开」,或者干脆闪退。
backend/core/gatekeeper_detect.py 的模块文档里明确写了它「只做检测」(detection only),从不执行 xattr -cr 去清除隔离属性,理由是:调用 xattr -cr 的那个进程自己也在被隔离的包里面,一样会被拒绝执行。所以它只能把操作指引推给用户,让人在终端里手动跑一次。
这是个很典型的坑——很多工具会假装自己能自愈。把「我修不了自己」写进注释里,反而说明作者真的踩过。
MCP 那一步,才是它跟普通语音 GUI 的分界线
市面上「本地跑 TTS」的方案不少,VoiceStudio 真正拉开差距的地方在它把自己同时做成了 Agent 的工具箱。文档 docs/mcp.md 给的工具表大概是这样的:
| MCP 工具 | 做什么 |
|---|---|
generate_speech | 文本转语音,默认用该 Agent 绑定的音色,也可传 profile_id 指定 |
clone_voice | 参考音频转成新的声音档案,返回 profile_id |
describe_voice | 把一段自由文本描述映射到音色属性(性别、年龄、音高、风格、口音),并告诉你哪些词它映射不了 |
design_voice | 按描述生成一个稳定身份的设计音色,拒绝映射不到任何属性的描述 |
transcribe | 音频转文本 |
list_voices / check_health | 列音色;查后端状态与当前生效的 GPU 设备 |
细节里有两处我很认同。一是 MCP 直接就挂在运行中的后端上(/mcp),不需要你再起一个进程;二是它给了 OMNIVOICE_MCP_OUTPUT_MODE 这个环境变量,因为 WAV 转 base64 塞进上下文非常烧 token——默认的 resources 模式内联返回音频数据,切成 files 或 both 就只返回一个可通过路径取用的文件。另一方面,读文件这件事被 OMNIVOICE_MCP_BASE_PATH 卡在一个目录内,符号链接会被解析后校验。给 Agent 开文件权限这件事,它没有偷懒。
CHANGELOG 里还能看到这条路线的延伸:MCP Agent 现在可以「用一段文字描述设计音色、存下来、之后靠 profile_id 复用」(#2368);未发布的版本里还有一个电话 Agent,可以用你自己的声音拨打或接听电话去完成任务(#2306)。看到这条我愣了一下——能力边界扩得很快,但那也是风险真正开始变大的地方。
什么时候我建议你别装它
说了这么多好处,该泼冷水了。下面这些是我认为最需要在动手前想清楚的:
| 场景 | 我的结论 |
|---|---|
| 想嵌进自己的闭源产品里卖 | 先看许可。应用本体是 AGPL-3.0,如果你改过它并通过网络对外提供服务,得把修改版的完整源码以同样的许可提供出去。它另外卖商业许可来豁免这条,官网标价是每人每年 99 美元、终身 299 美元(价格以官网为准,我发文时没在页面上下单核对)。 |
| 商用默认引擎的合成音频 | 谨慎。应用许可不等于模型许可。默认的 k2-fsa/OmniVoice 代码是 Apache-2.0,权重标注 CC-BY-NC,内部 tokenizer 还叠了第三方条款。要商用得逐个模型确认。 |
| Intel 芯片的 Mac | 不用试。官方支持表里写得很直接:Intel Mac 只能跑 App 界面,语音得连远程后端(就是上面说的 :3900)。 |
| Windows on ARM(骁龙 X 之类) | 官方标注为实验性、验证未完成:原生 ARM64 外壳 + 模拟运行的 x64 Python 后端,且只能走 CPU。 |
| 没有独立显卡 | 能跑,但慢。CPU 路线要下载约 5GB 的 PyTorch CPU 版;第三方报道称默认引擎建议至少 6GB 显存才能有效加速(这条来自外部分析,非官方硬件表,供参考)。 |
| 想开箱即用、不想折腾依赖 | 做好心理准备。十六个引擎各带自己的 Python 环境,模型要按需下载(默认那个约 2.4GB),首次配置和排障不是零成本的。 |
| 想克隆别人的声音 | 别。README 里明确写了只能在获得声音权利人许可的前提下使用。这不是免责声明,是底线。 |
反过来说,如果你的素材是医疗、法律、企业内部这类完全不能出内网的录音,或者你已经有 GPU、又想把「文章转播客」这种任务挂进自动化流程里,那它现在这个形态是合适的——本地 API 加 MCP 这一层,比大多数同类项目都做得完整。
至于那五万 star 里有多少是真在用、多少是收藏夹吃灰,我没法验证。能被社交传播一夜推上 Trending 的项目,通常都要过一年才知道谁留下来了。我的判断很简单:它值不值得留,不取决于它的模型有多强,取决于那层编排够不够稳——毕竟模型你可以随时换,把十六个互相打架的环境缝成一个能长期用的东西,才是这个项目真正的活儿。
一句话总结:VoiceStudio 的护城河不在模型里,在它把一堆开源语音能力缝成「桌面壳 + 本地服务器 + Agent 接口」的那层编排上。动手前先确认两件事——你的机器撑不撑得住,以及你要拿它生成的东西能不能商用。