前两天刷到个仓库,cloudflare/security-audit-skill,Cloudflare 六月才开的库,到我写这篇时已经 1.6 万 star、917 个 fork。我第一反应是:又一个"让 AI 帮你找漏洞"的玩具?clone 下来读了一圈,发现它和我预想的不太一样——它不承诺帮你扫出漏洞,反而把大部分精力花在"怎么才能不瞎编漏洞"上。本地把它的工具链跑通之后,我觉得这个项目值得拆开讲讲。
它真正想治的,是 Agent 审计最容易犯的错
让大模型审代码,最危险的结果不是漏报,而是把"我猜这里有洞"包装成"已确认的高危漏洞"。这种幻觉一旦进了报告,比没有报告还糟。这个 skill 的整个设计都在压住这种冲动:它规定只有"完整源码溯源 + 本地可复现的最小结果"才算 confirmed,否则一律降级成 needs_validation(待验证)。它其实是 Cloudflare 内部漏洞猎探体系(vulnerability harness)的开源起点,那套体系后来长成了多阶段、规模化的系统,这个仓库是它最初演化出来的形态。
流程:六个阶段,而且验证的人永远不是发现的人
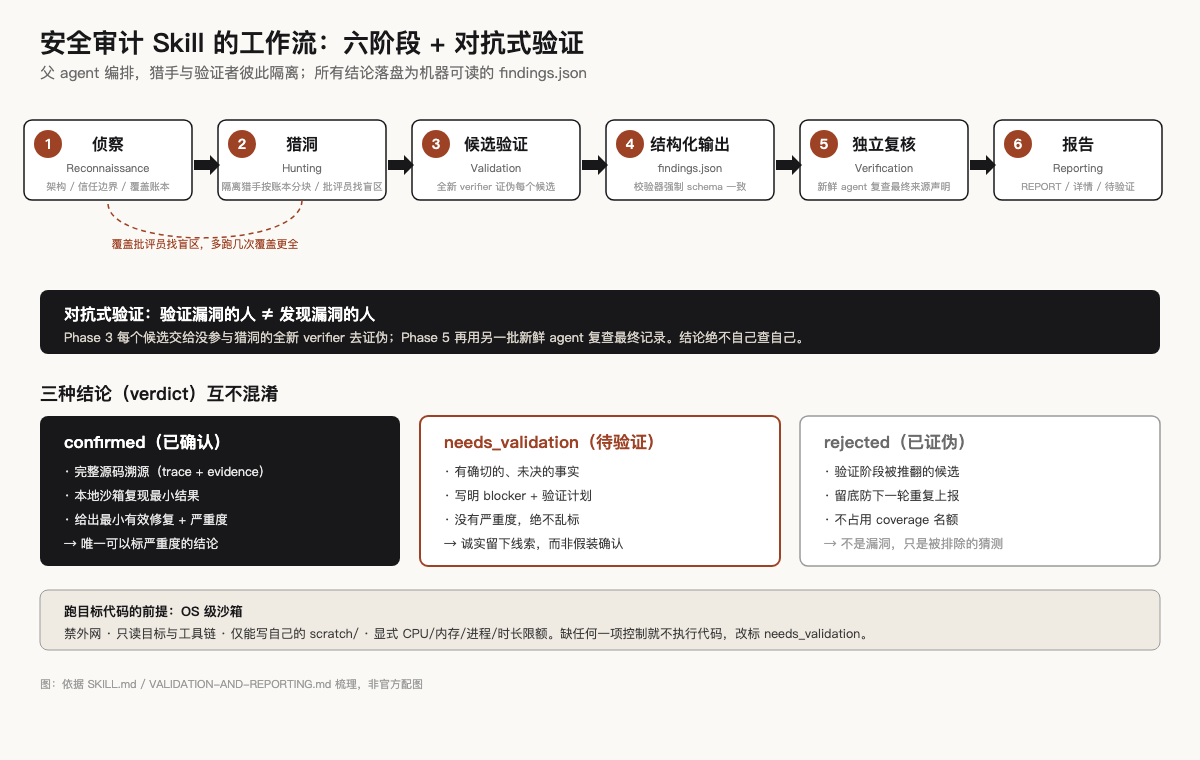
完整审计模式(full audit mode)下,它强制走完六个阶段,父 agent 负责编排,底下派出去的猎手(hunter)和验证者(verifier)彼此隔离、各写各的 scratch 目录:
- 侦察:画架构、信任边界、输入面,落成 architecture.md 和 coverage-ledger.json(覆盖率账本)。
- 猎洞:按账本分块派隔离猎手,再用"覆盖批评员"找盲区;一轮不够就多来几轮。
- 候选验证:每个可疑点交给一个没参与猎洞的全新 verifier,任务是去证伪它。
- 结构化输出:把结论写进 findings.json,并用 report-schema.json 强制校验格式。
- 独立复核:再用另一批新鲜 agent 复查最终记录,关键改动还要再找第三人验。
- 报告:从已验证记录里衍生出 REPORT.md、FINDINGS-DETAIL.md、NEEDS-VALIDATION.md。
这里最硬的一条规则是:验证漏洞的人,绝不能是发现它的人。Phase 3 和 Phase 5 用的是两批不同的独立 agent,自己查自己在这套流程里被物理上隔开了。我个人觉得这正是它和"agent 随便扫一圈就出报告"的本质区别。
三种结论,而且互不混淆
这个 skill 最克制的地方,是它把"不知道"单独留了一个等级,而不是强行往"确认/排除"里塞:
| 结论 | 含义 | 有严重度吗 |
|---|---|---|
| confirmed | 完整源码溯源 + 本地沙箱复现了最小结果 + 给了最小有效修复 | 有(likelihood × impact) |
| needs_validation | 有确切的、未决的事实挡着,写明了 blocker 和验证计划 | 没有,绝不乱标 |
| rejected | 验证阶段被推翻的候选,留底防止下一轮重复上报 | 没有 |
我刚读到这套设计时有点意外:它宁可把一堆线索老老实实标成"待验证",也不肯给个 severity 凑数。report-schema.json 里 needs_validation 分支干脆就不允许出现 severity 字段,从数据结构上堵死了"假装有把握"。
我在本地跑了一遍它的校验器
环境:macOS,用的是托管的 Node v22.22.2。仓库本身没有任何构建步骤,clone 完直接就能跑它的两个零依赖校验脚本。我先把自带的测试套件跑了一遍:
git clone --depth 50 https://github.com/cloudflare/security-audit-skill
cd security-audit-skill/skills/security-audit
node --test validate-findings.test.cjs        # 34/34 通过
node --test validate-coverage-ledger.test.cjs  # 31/31 通过
接着我手工造了一条合法 findings 和一条故意缺字段的非法 findings,喂给校验器,看它怎么反应:
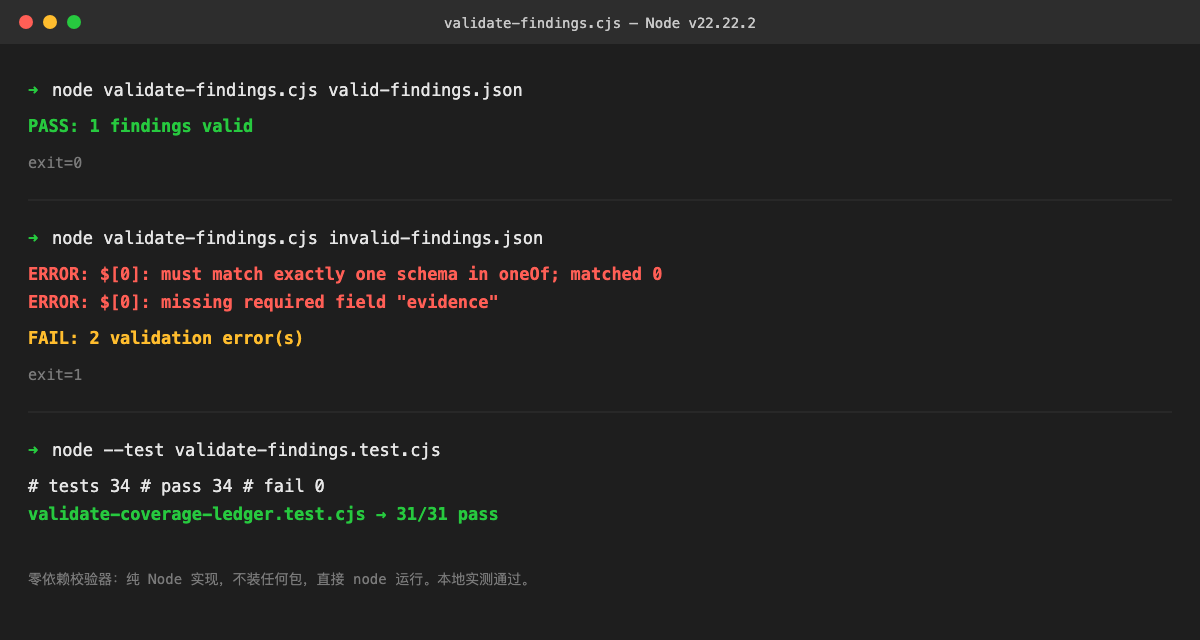
node validate-findings.cjs valid-findings.json
# PASS: 1 findings valid        (exit 0)

node validate-findings.cjs invalid-findings.json
# ERROR: $[0]: must match exactly one schema in oneOf; matched 0
# ERROR: $[0]: missing required field "evidence"
# FAIL: 2 validation error(s)    (exit 1)
几个只有跑过才知道的点
- 真零依赖。整个 skill 不需要 npm install 任何一个包,校验器就是裸 Node 脚本。对"塞进 agent 工作流"这件事很关键——agent 不必先等依赖装好,node 一调就走。我 clone 后第一条命令就是直接 node 运行,没有任何前置安装。
- 校验器自己先做了安全加固。读源码时看到它对输入做了终端控制字符过滤(\x1b、\x07、\u202e 这类),用 O_NOFOLLOW / O_NONBLOCK 标志安全打开文件,还限制了输入 5 MiB、最多 1000 条、嵌套 64 层。一个"给别人校验安全产出"的工具,自己先把路径穿越和恶意输入防住了,这态度我挺服气。
- additionalProperties:false 是真生效的。我故意造的那条缺 evidence 的记录,它直接报 "missing required field evidence" 并 exit=1,而不是默默吞掉。这套 schema 不是装饰,是真的在卡结构一致性。
- 测试用的是 Node 自带 node:test。不需要 jest / mocha,Node 22 下直接 node --test 即可,两个套件共 65 个用例全绿。
什么场景该用,什么不该
| 场景 | 结论 |
|---|---|
| 中大型、攻击面复杂的项目,想做一遍严肃、可留痕、可重复的审计 | 适合。它的账本 + 对抗式验证正好解决"每次审计各做各的、不可比"的问题 |
| 信不过 agent 随口"确认漏洞",想要机器可读结论和独立复核 | 适合。这正是它设计的第一目标 |
| 想要一个一键扫描器(类似 SQL 注入 / 依赖漏洞扫描) | 不适合。它靠 agent 读源码 + 沙箱复现,慢且贵,不是扫描器 |
| 运行环境没有 OS 级沙箱,也不打算配 | 不适合。缺任何一项沙箱控制,它就拒绝执行目标代码、改成标 needs_validation,等于没真查 |
| 小项目偶尔自查一下 | 杀鸡用牛刀。直接让 agent 读代码提建议更快 |
顺带说一句局限:我没真拿它去审计一个真实项目,因为完整跑一遍需要 OS 级沙箱(禁外网、只读目标、只允许写 scratch、显式资源限额)和相当可观的 token 预算。本文聚焦在把它的设计读透、把它的工具链在本地跑通这两件事上。
一句话总结:它不是一个"帮你找漏洞"的工具,而是一个"逼着 agent 对漏洞结论负责"的流程。如果你受够了 AI 审计报告里那些查无实据的高危标记,这个仓库的纪律感值得抄。
项目地址
本文分析的仓库:github.com/cloudflare/security-audit-skill(Cloudflare 官方开源,MIT 协议)。clone、跑校验器、读源码的全过程都基于这个仓库,文中所有命令可直接复现。