先把结论说了:AIHOT 这个仓库,最值得抄的不是那 27 份提示词,是它夹在提示词外面的三处工程——付费调用先写回执、热度按独立来源算、两篇报道合并前要第二家模型点头。这三处跟「AI」其实没多大关系,全是被人踩疼过才会长出来的东西。
我花了一个下午把仓库 clone 下来读源码。没跑起来,一行都没装——就是读。所以下面所有判断要么有 path:line,要么有官方文档,我会标清楚哪些是我读出来的、哪些是作者自己说的。
| 项目名片 | 信息 |
|---|---|
| 项目地址 | github.com/KKKKhazix/AIHOT |
| 线上站点 | aihot.news |
| 主要语言 / License | TypeScript / MIT(站名与 Logo 不在许可范围内) |
| Stars(发文时实查) | 2,966,fork 847(2026-09-30 查,会变) |
| 仓库年龄 | 2026-09-28 创建,2026-09-29 最后推送——两天 |
| 适合谁 | 想给自己行业做「自动盯热点 + 自动出日报」站点的团队或个人,且愿意自己写分类、信源和精选标准的 |
它到底是个什么东西
一句话:一个把「采集 → 模型筛选 → 聚簇 → 出刊」整条流水线打包好的站点框架。默认配置是个 AI 行业站,你把行业包换掉,它就是你那个行业的站。
和「AI 新闻聚合器」这类东西最大的区别是它把流程拆得很细。一条资料进来之后要走六步:判重、预筛、两次独立评分、写中文标题摘要、结构化成事实、归组进事件。最后热度按事件排,每天早上 08:00 出日报。
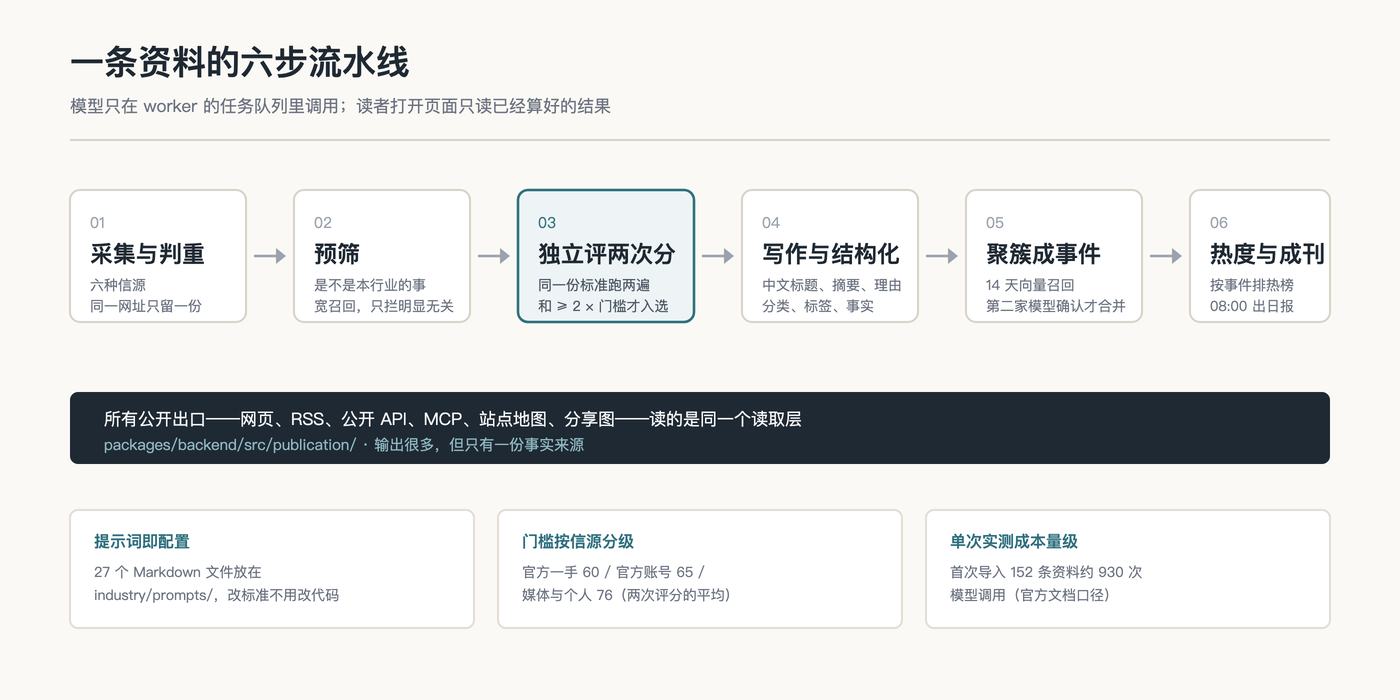
industry/prompts/ 里,改标准不用改代码。有两个细节我挺喜欢。第一,页面不调模型。读者打开页面只读数据库里已经算好的结果,模型调用全部发生在 worker 的任务队列里(docs/architecture.md:27)。这意味着流量再大也不会把模型账单顶起来——很多同类项目栽在这上面。第二,公开出口只有一个读取层:网页、RSS、公开 API、MCP、站点地图、分享图读的都是 packages/backend/src/publication/(docs/architecture.md:26)。输出多,但只有一份事实来源,不会出现「RSS 里有、网页上没有」这种鬼故事。
技术栈没什么花活:Node.js 24 直接跑 TypeScript(后端没有构建步骤),Fastify + React Router SSR + PostgreSQL,任务队列用 pg-boss。三个进程——api、worker、web——互相之间只走 HTTP 和数据库。仓库里 TypeScript 一共约 4.2 万行,其中后端 1.8 万行、前端 1.45 万行,配了 40 个测试文件和 35 个数据库迁移。
两天涨到近 3000 star,火的原因不全在代码里
我平时不太写「某某项目火了」这种话,但这次的数据确实反常:9 月 28 日建仓,9 月 29 日推最后一批提交,到 30 日早上我查的时候已经 2,966 star、847 fork。两天。
原因我看有两层。
一层是作者本身。作者是数字生命卡兹克,中文 AI 圈里做「AI 热点资讯」很出名的一个人,aihot.news 就是他自己的站。他在发布文里说这个站月活到了百万量级,还有近 10 万用户装了基于它的 Skill——这两个数字是他自己的说法,我没有独立渠道核实,姑且标一下。他自己也承认了以前不开源的原因是「架构做得实在太烂,是个大型屎山」,改一个地方另一个地方出 bug,每天飞书上十几条告警。
另一层原因有点反直觉:这个仓库本身就是用 AI 重写出来的。按公开报道的说法,他花了三天做这件事——先用两个模型并行把旧代码库读成交接文档,再让第三个模型拿文档去核对老代码,然后写代码的模型完全不看旧代码、从零重写(大约 12 小时),最后一轮多个模型并行做逐行审计、找漏掉的功能和 bug,最后重做前端。作者六天前还是个看不懂代码的设计师。
所以这个仓库火起来,一半是因为内容本身有用,另一半是因为「一个设计师用 Agent 把百万月活的站重写干净了还开源」这件事本身就很有传播力。这两件事得分开看——别把传播热度自动读成代码质量。
暗牌一:钱要先记账,再花
这是我读完最想抄的一段,在 packages/backend/src/providers/receipts.ts。文件头那八行注释基本把设计意图写完了:
// Paid requests (models, SocialData, Jina, Dajiala) go through here.
//
// 1. A logical request has a stable key bound to task, input revision, provider, model, prompt and config.
// 2. Before calling, a placeholder row and an attempt row are persisted; budgets count attempts.
// 3. The raw response is saved before any business write; recovery reuses a received response.
// 4. A request whose outcome is unknown (timeout after sending, crash mid-flight) is not re-sent by the
//    caller. ops.recover releases it once after 30 minutes (admin/runs.ts), so a lost answer costs at
//    most one repeat; after that it waits for the admin.
翻译成人话:每次要掏钱的调用,先往数据库写一张「回执」,拿到答案先存回执,再做业务写入。这样进程被杀、任务重试、worker 重启,都能靠回执复用已经付过钱的那次结果,不会重复扣费。逻辑键是把任务、输入版本、服务商、模型、提示词一起哈希出来的(receipts.ts:71-74),所以「同一份输入 + 同一份提示词」天然只付一次钱。
更让我意外的是它对失败的分类。调用出错时它会判断这错误属于哪一种:
const status = error instanceof ProviderRejectedError ? "failed" : "unknown";
// "unknown": the request may have reached the provider (timeout, reset): do not re-send automatically.
(receipts.ts:154-156)服务商明确拒收才算 failed,可以重试;超时、连接被重置这类「不知道对方收没收到」的情况一律记成 unknown,绝不自动重发。因为重发可能就是第二次付费,而且如果第一次其实成功了,你等于花了两次钱拿了一份结果还得去重。这个判断很少见到有人认真做。
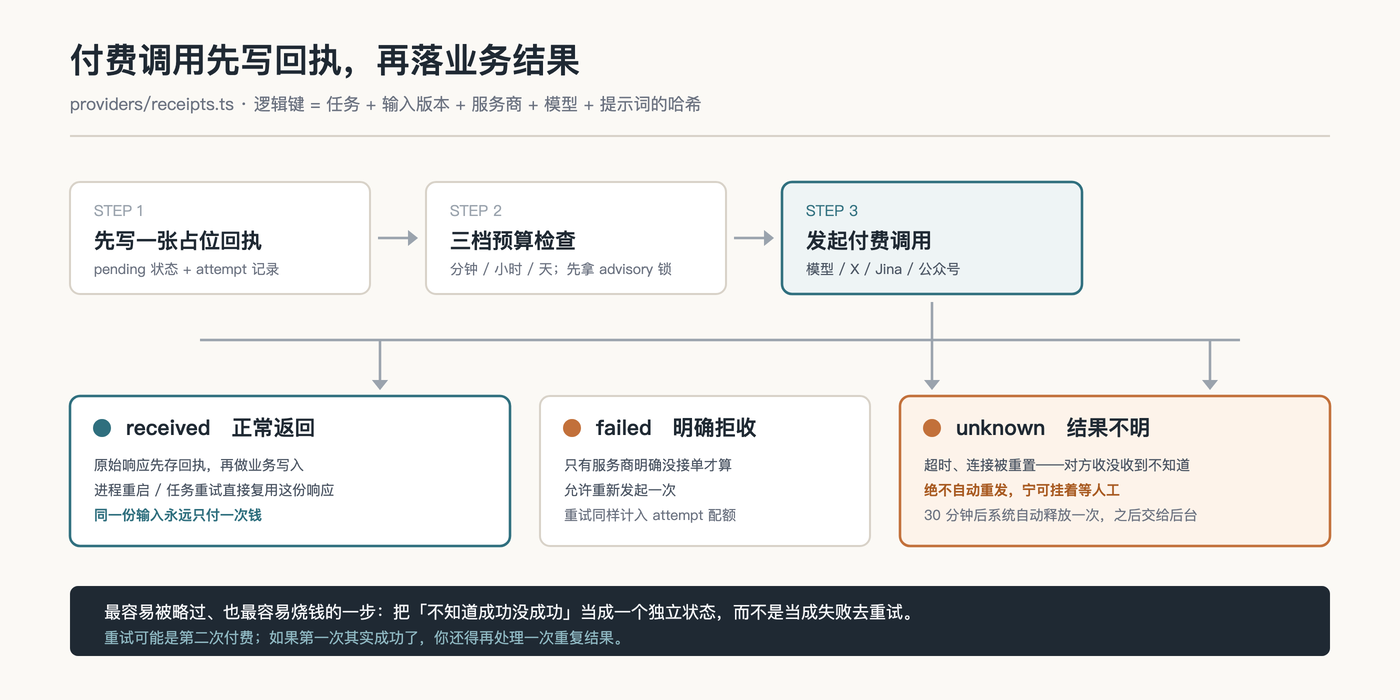
unknown:宁可挂着等人工处理,也不赌一把重发。回执外面还有一层预算熔断。每个付费服务有每分钟、每小时、每天三个上限,检查的时候先拿一把数据库的 advisory 锁(receipts.ts:114),并发 worker 没法一起冲过线。per_minute、per_hour、per_day 任意一个是 0,整个服务直接停用(receipts.ts:97),等于是个不带商量的总闸。重试也算一次 attempt,所以「失败重试刷爆配额」这条路也被堵了。
顺手说个能当参考的成本量级:官方文档里写,用示范信源在本地首次导入 152 条资料,一共用了大约 930 次模型调用(docs/deploy.md「花多少钱」一节)。也就是说一条资料平均 6 次调用——预筛一次、评分两次,入选的再加写作、结构化、归组、综述。想自己算账单的话,这个倍率可以直接拿去乘。
暗牌二:热度榜不该被「同一家媒体发十篇」刷上去
聚合类产品最容易崩的地方就是榜单。你按文章数排,那谁家稿子多谁说了算;你按转发量排,那刷量的人说了算。AIHOT 的做法是把计分单位从「文章」换成「事件」,再限定成「独立参与者」。
规则就写在 packages/backend/src/events/hot.ts 开头,四个常量:
export const HOT_RULE_VERSION = "heat-v1-48h-halflife24h";
const WINDOW_HOURS = 48;
const HALF_LIFE_HOURS = 24;
const MIN_PARTICIPANTS = 2;
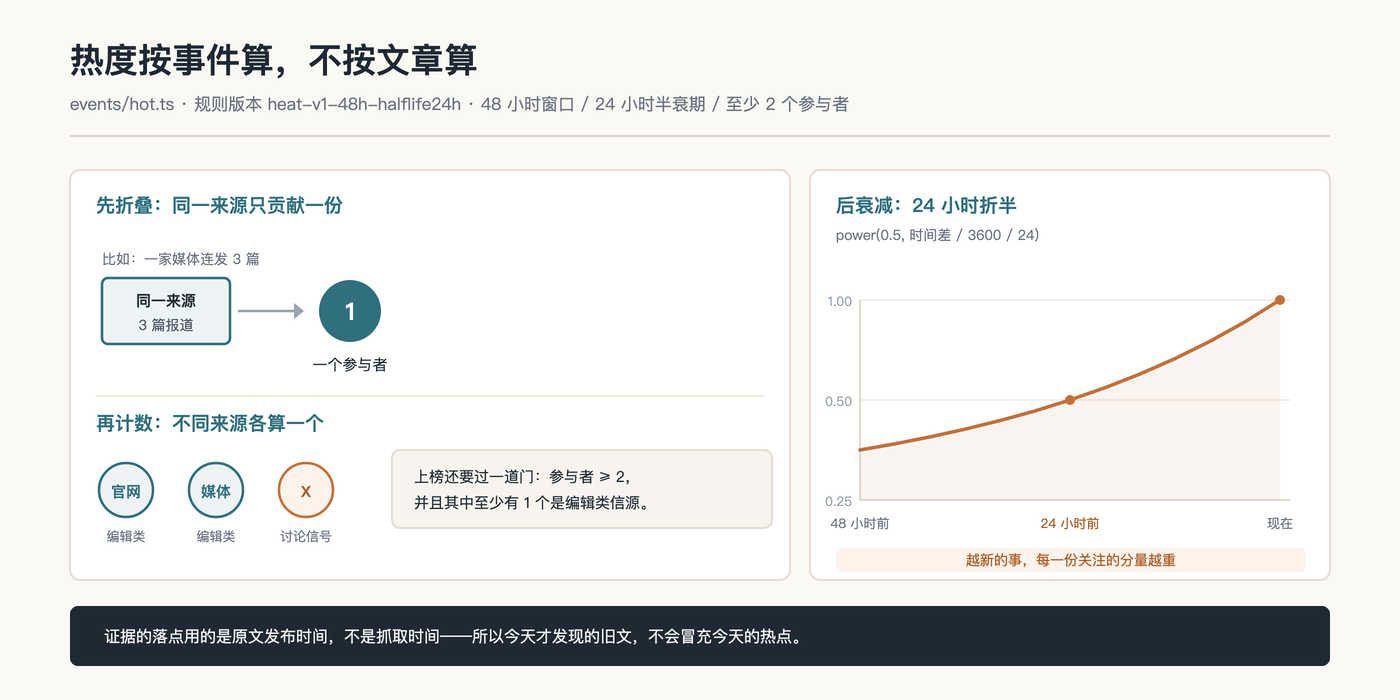
(hot.ts:7-10)48 小时窗口、24 小时半衰期、至少要 2 个参与者才能上榜。衰减是真按公式算的,热度的 SQL 里直接写 power(0.5, 时间差 / 3600 / 24)(hot.ts:56),也就是每过 24 小时贡献减半。
但真正关键的是分组那一步。同一个 participant_key 在窗口里只 count(*) 一次,重复抓取不会加温;同一家媒体发十篇,也只算一个来源。而且证据的落点是原文时间(observed_at)不是抓取时间,所以「今天才发现的一周前的旧文」不会冒充今天的热点。上榜还得过一个额外条件:参与者 ≥ 2 且其中至少有 1 个是编辑类信源(hot.ts:93),纯社交平台的讨论热度不能单独把一个事件推上榜。
还有个我觉得挺细的地方:它会判断某个信源「是不是落后了」。如果某个源超过三个抓取周期(最少 90 分钟)没成功抓过,这一小时的快照会被标成 complete = false 从图表里剔除,等这个源补齐之后再重算(hot.ts:169-193)。也就是说它宁可让曲线上少一个点,也不给你画一条假的下跌。
暗牌三:要合并,得先问第二家模型
「同一件事被写十遍」是这类站点的另一个死法。AIHOT 的归组走两步:先召回,再判断。
召回靠向量,只看最近 14 天,余弦相似度低于 0.6 的候选直接扔掉(group.ts:35-36)。召回一批候选之后交给模型做三选一判断:同一件事(SAME_OCCURRENCE)、有直接关系的后续(SAME_STORY)、还是没关系。
关键在下面这段:
if (pick.score >= CONFIRM_BELOW_COSINE) { /* 相似度够高,直接合 */ }
// 否则:换一家模型再确认一遍才写入
(group.ts:39 定义了 CONFIRM_BELOW_COSINE = 0.85,判断在 group.ts:675 附近)相似度高的候选直接合,相似度低的合并必须由第二个服务商的模型点头。这个设计既省了钱,又挡住了「一家模型的偏好决定全站聚类结果」这件事。
文件头的长注释还交代了几条我原以为不会有人处理的规则:同一个跟进进展只能挂在开启这个事件的那条事实上,所以事件不会靠链式关联合并滚雪球;人工改过的归属永远不会被自动流程覆盖;如果一个事件因为重新归组而失去了全部报道,它会合并到报道去的地方,让原来的地址继续能用。最后这条是给 SEO 和外部链接留的后路,做内容站的人应该能体会。
那 27 份提示词呢?确实是明牌
说回大家最关心的部分。作者把生产环境在用的提示词全放出来了,industry/prompts/ 下 27 个 Markdown 文件。真正有分量的是评分标准 selection-score.md,它的做法是把评分拆成五个轴先各自打 0–10 分:实质份量(sig)、信息增量(nov)、证据强度(cred)、共振面(reson)、可用性(act),然后再按内容类型套一张权重表:
| 类型 | sig | nov | cred | reson | act |
|---|---:|---:|---:|---:|---:|
| model_release   | 3 | 2 | 2 | 2 | 1 |
| product_launch  | 2 | 2 | 1 | 2 | 3 |
| tool_or_prompt  | 1 | 2 | 1 | 2 | 4 |
| research_paper  | 5 | 3 | 1 | 0 | 1 |
| industry_event  | 3 | 1 | 2 | 4 | 0 |
(selection-score.md:44-52,完整表里是 7 类)每行权重加起来是 10,加权求和天然落在 0–100 之间,不用再归一化。而且提示词里明确写了两句我很认同的话:不要把五轴先求平均;不要为了靠近门槛而改写计算结果。论文类的 reson 权重是 0——意思很直白,普通读者不关心和你无关的论文。
比权重表更有价值的是「噪声压制」那一节。它不是抽象地说「要压缩低质量内容」,而是给了可判定的上界,比如:客户案例类 PR 没有明确任务规模和可迁移方法时 sig ≤ 4;例行小版本、只接入另一个模型、普通修复 sig ≤ 3;多事件打包的早报周报 sig ≤ 3。这种能落到具体数字的口味才是真正的 KnowHow,也是这个仓库最该被抄的部分。
入选门槛单独放在 industry/selection.ts,按信源分级区分:官方一手 T1 要 60 分,官方账号 T1.5 要 65,媒体和个人 T2 要 76。同一份评分标准独立跑两遍,两次之和达到 2 × 门槛 才入选,卡片上显示的是两次的平均值(向下取整)。跑两次不是为了取平均消噪声——看代码它更像是用独立性换一个更稳的准入判断(analyze.ts:46、:377-380)。
顺便,门槛这东西作者反复强调别凭感觉改,要先标 100–200 条自己的样本跑 scripts/eval-selection.ts,看查准率查全率,再回头改标准,最后才动门槛。他把这个顺序写死在文档里了:先改标准,再动门槛,因为门槛只能整体平移,解决不了「哪一类判错了」。我见过太多人上来就调阈值,这是错的。
我会在什么情况下用它,什么情况下不用
先说清楚一件事:我这次只读源码、没部署,所以下面关于「跑起来顺不顺」的判断都是从文档和代码推的,不是实测。这点我认。
| 场景 | 我的结论 |
|---|---|
| 自己有明确行业 KnowHow、想搭一个垂直资讯站 | 值得上。信源、分类、提示词、门槛全在一个 industry/ 目录里,代码基本不用动 |
| 关心模型成本可控 | 值得上。回执 + 预算熔断是现成的,这是我最想抄的一块 |
| 要做「人看 + Agent 读」双出口 | 值得上。RSS、公开 API、MCP、llms.txt 一起给了 |
| 想要开箱即用、不碰代码的 SaaS | 不合适。这是「跑在你自己服务器上的一套东西」,Docker、数据库、模型账单全是你的 |
| 没有行业 KnowHow,只是想抄个 AI 站 | 不合适。它连作者的 18 个示范信源都是公开海外源,真正的信源名单没放出来,评分标准里 AI 领域的例子你也用不上 |
| 要求有版本保证、长期同步上游 | 不合适。作者自己说这是一份快照,未来每次迭代「只能说我尽量」同步 |
另外有几个坑我认为得提前知道。
- 仓库里只有 18 个公开海外 AI 信源,而且全是 RSS。它支持六种信源(RSS、网页列表、JSON 接口、X 账号、公众号、外部推送),但 X 要 SocialData 的 key、公众号要极致了的 key,都是按请求另外付费的。
- 服务器如果在中国大陆,抓海外源要自己配代理(
EGRESS_PROXY_URL)。文档里专门有一节讲这个。 - 作者六天前才「看懂代码」,这个仓库是 AI 重写出来的快照。作者的坦白我反而觉得是加分项,但它确实意味着某些模块的成熟度需要你自己验一遍——比如跑一遍
npm run typecheck和那 40 个测试文件。 - 站名和 Logo 不在 MIT 许可范围内,得换成自己的。
这两天大家都在转「百万月活的 AI 站开源了」,热度是真的。但如果真想拿它干点什么,我建议先看 receipts.ts 那 200 行——那里面没有一行 AI,全是「怎么不把钱和结果搞坏」,这种代码比提示词更难写,也更容易被漏掉。